2026年9月24日,实验室5篇论文被NeurIPS 2026接收。NeurIPS会议的全称是 Annual Conference on Neural Information Processing Systems,是人工智能领域的顶级会议。会议将于2026年12月6日至12月13日在澳大利亚悉尼主会场、美国亚特兰大和法国巴黎分会场召开。
被录用论文的简要介绍如下:
1. Geometric Prompt-Trajectory Planning for Test-Time Scaling (Zhengqi Pei, Anran Zhang, Qingming Huang, Shuhui Wang)
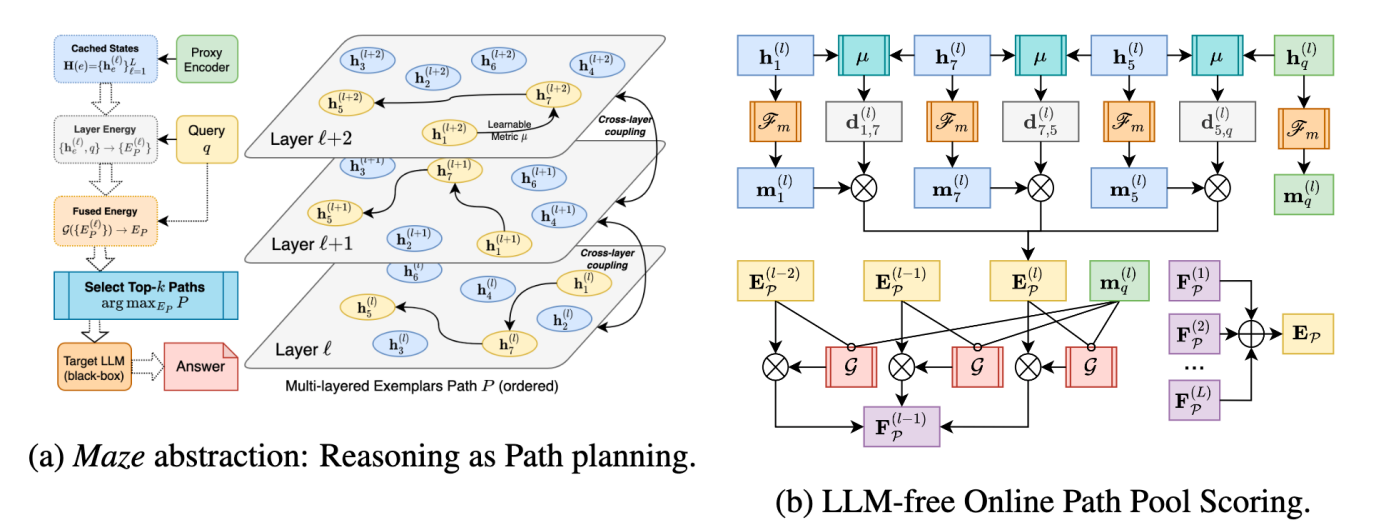
测试时计算扩展(Test-Time Scaling, TTS)通过增加推理阶段的计算投入提升大语言模型的推理能力。然而,以重复采样和结果聚合为主的扩展策略,往往使计算成本随模型调用次数近似线性增长,且难以充分克服不同候选解共享错误模式所带来的局限。针对这一问题,我们提出基于几何提示轨迹规划的测试时扩展框架 Maze,将部分计算投入从目标模型的重复生成转移至生成前的提示规划。其核心思想是将少样本示例的有序组合建模为潜在几何空间中的提示轨迹,使示例的选择、排列及其与当前问题的关联成为可联合优化的结构。借助预缓存的编码器表征与轻量级可学习评分函数,Maze 无需调用目标模型逐一试验候选提示,即可完成轨迹评估与排序,并仅对优选轨迹执行一次或少量模型调用。规划器与目标模型相互解耦,无需访问目标模型的内部参数或隐藏状态,因此能够适用于黑箱模型部署。在涵盖专业知识、科学问答与数学推理的五项基准测试中,Maze 在单次调用条件下持续优于所比较的提示优化方法,其多次调用扩展 MultiMaze 则以更少的模型调用和更低的推理延迟,获得多次采样策略的大部分性能增益。理论分析进一步刻画了这一转化的适用条件:当候选集合充分覆盖高效用提示轨迹,且评分函数能够可靠地识别其相对优劣时,增加规划侧的搜索投入可以替代部分生成侧的重复采样。这项研究为高效推理提供了一个新的视角:推理能力的扩展不仅取决于计算投入的规模,也取决于计算资源的配置方式;在生成之前优化提示结构,是提升每次模型调用效用的重要途径。
2. KV Cache Compression via Attention Output Distortion Minimization (Yi Wang, Yixuan Cao, Qiang Ding, Zelin Gao, Ping Luo)
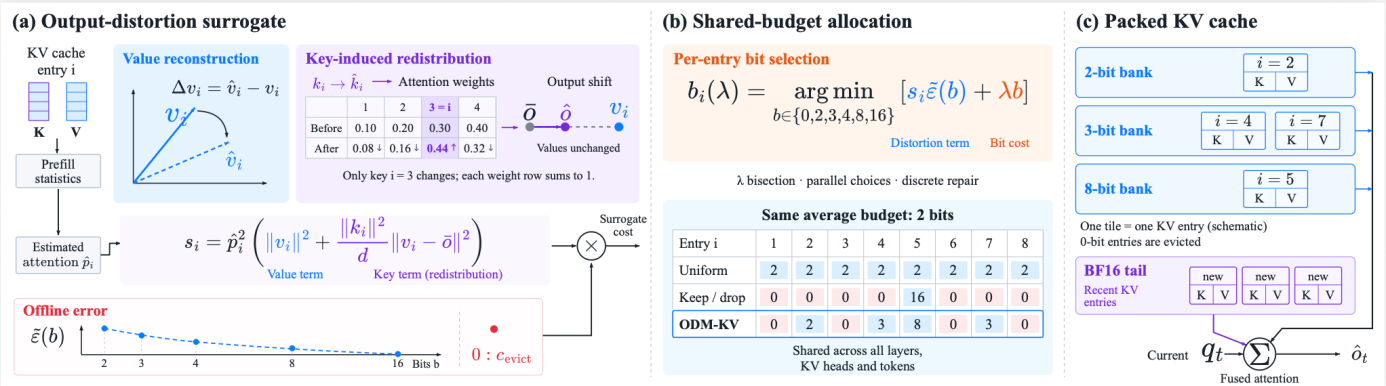
高效的长上下文推理要求在严格的内存预算下压缩 KV 缓存,同时不降低模型的输出质量。我们将这一问题表述为一个约束优化问题:在统一的平均位宽预算约束下,最小化注意力输出的总失真,其中每个 token 的 KV 条目均可分配不同位宽,从 0 比特(淘汰该条目),经过各种混合精度选项,直至 16 比特(不压缩)。核心挑战在于估计每个 token 对注意力输出失真的贡献。为此,我们对注意力机制进行一阶扰动分析,为失真的可分离近似提供依据。具体而言,我们将每个 token 的压缩代价近似为以下两项的乘积:(i)针对该 token 的风险分数,用于衡量注意力输出对该条目扰动的敏感程度;(ii)由所选位宽决定的、与精度相关的量化误差。在这一近似的基础上,我们通过拉格朗日松弛进行位宽分配,将松弛后的问题化为相互独立的逐 token 决策。在 LongBench 和 RULER 上,使用Llama-3.1-8B-Instruct 和 Qwen3-8B 进行的实验表明,我们的方法仅需平均每个条目 2 比特,即可达到与统一 4 比特量化相当的准确率。在平均位宽为 1 比特时,我们的方法仍能保持显著高于统一量化和 token 淘汰基线的准确率,而这两类基线在此条件下的性能均急剧下降。我们还为 ODM-KV 实现了一套原生混合位宽推理系统,能够减少 GPU 显存占用,并可在较大的批量大小下提高解码吞吐量。
3. Masked Diffusion Language Agents for Tool-Integrated Chemical Reasoning(Mengdi Liu, Chenghao Jia, Hong Chang, Shiguang Shan)
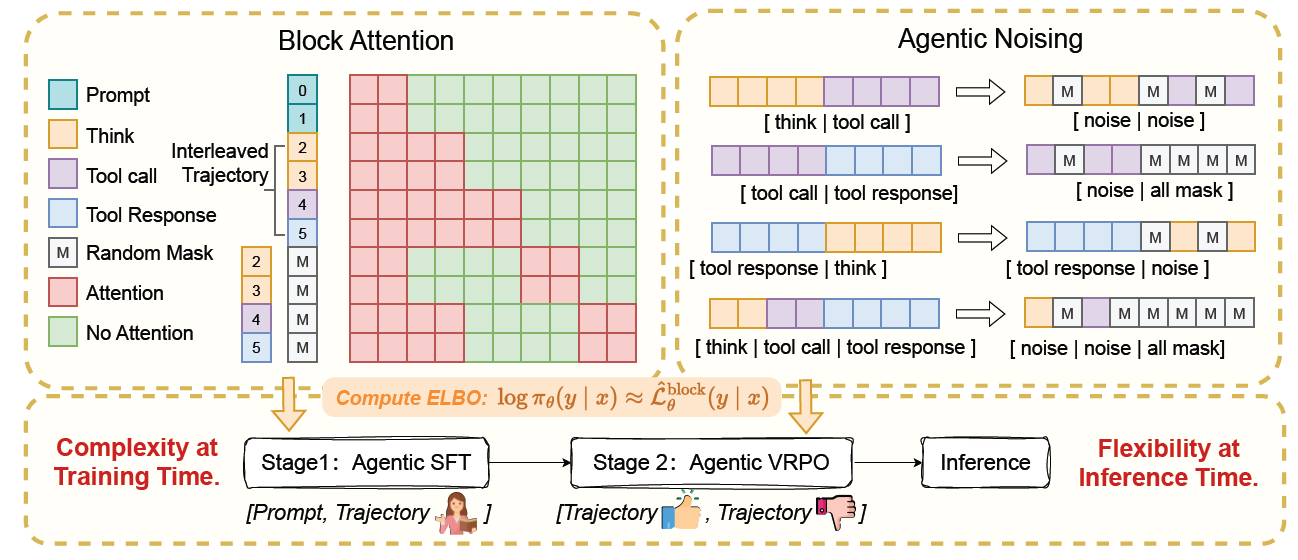
构建用于复杂化学任务的工具集成推理智能体仍面临巨大挑战。现有自回归(AR)智能体受限于因果注意力与单向生成,难以实现双向分子理解、全局协同工具规划及多源证据融合。为此,我们提出ChemDiffAgent——首个基于掩码扩散语言模型的工具集成化学推理智能体。该方法将化学推理重构为交织推理与工具调用的迭代去噪过程,使工具决策能够在全轨迹全局上下文下协同确定,从而更好地对齐智能体的决策边界与知识边界。文中深入探讨了掩码扩散范式如何通过训练期的难填空子问题与推理期的任意顺序解码赋能智能体推理。此外,我们设计了智能体监督微调和方差降低偏好优化两阶段后训练框架。在涵盖单轮与多轮工具调用的 6 项化学任务综合基准测试中,相同预算下 ChemDiffAgent 较 AR Agent 实现约20% 的整体性能提升;其 8B版本性能即可媲美甚至超越 GPT-5.5 和 Claude Opus 4.7 等前沿大模型。
4. AnyMo: Scaling Any-Modality Conditional Motion Generation with Masked Modeling(Yiheng Li, Zhuo Li, Ruibing Hou, Yingjie Chen, Hong Chang, Hao Liu, Shiguang Shan)
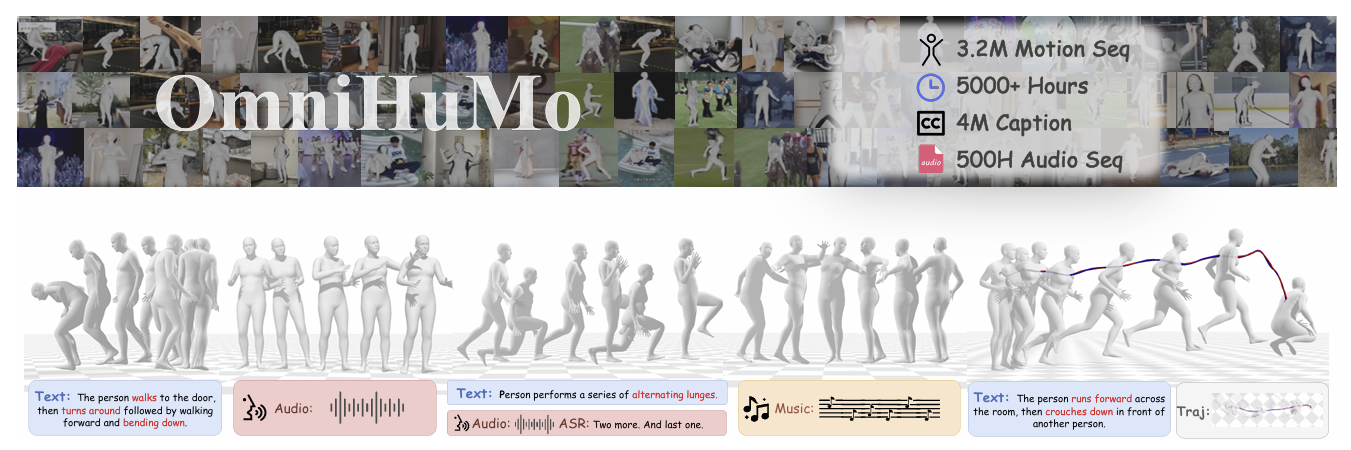
人体运动生成旨在根据文本、语音、音乐等条件自动生成自然、连贯的人体动作,是计算机视觉与多媒体生成领域的重要研究方向。然而,现有方法通常针对单一模态或特定模态组合进行设计,同时受限于人体运动数据规模和多模态标注不足,难以实现灵活、统一的多模态运动生成。针对这一问题,论文提出了大规模多模态人体运动数据集 OmniHuMo以及统一的多模态人体运动生成框架AnyMo。OmniHuMo从互联网视频中构建人体三维运动数据,并结合文本、语音和音乐等信息,形成超过 5000小时、320万条运动序列的大规模数据集。在此基础上,AnyMo采用基于 Residual Finite Scalar Quantization(R-FSQ)的运动表示方法,将连续人体动作编码为离散Token,并利用掩码Transformer统一建模文本、语音、音乐和运动轨迹等不同模态的条件信息,从而支持任意模态组合的人体运动生成。实验结果表明,随着训练数据规模和模型规模的扩大,人体运动重建和生成性能均得到显著提升;同时,引入运动轨迹等额外模态信息能够进一步改善生成动作的语义一致性与空间控制能力。该研究通过大规模多模态数据集与统一生成模型的结合,为人体运动从单一条件控制向通用多模态生成发展提供了新的技术路径。
5. Component-Based Out-of-Distribution Detection (Wenrui Liu, Hong Chang, RuiBing Hou, Shiguang Shan)
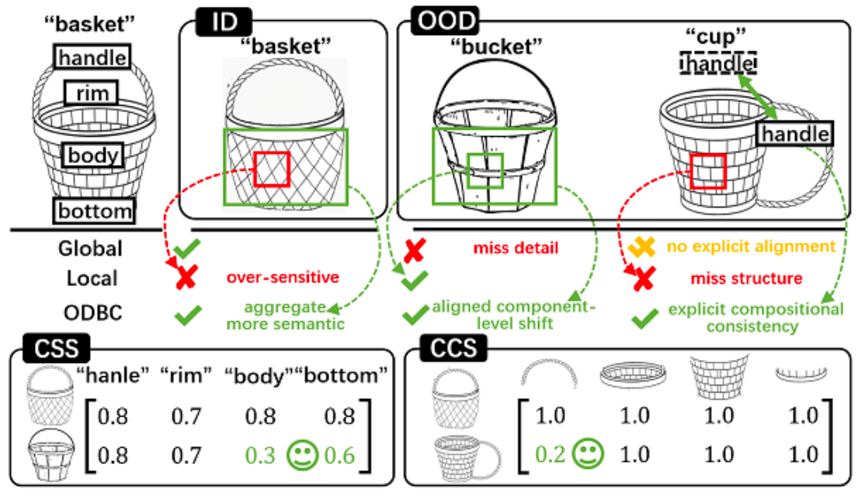
现有分布外检测(Out-of-Distribution Detection,OOD)方法通常依赖全局或局部表征:全局表征虽然能够有效识别较大的语义变化,却容易在特征聚合过程中忽略细粒度的局部异常;局部表征能够保留更多细节,却容易受到噪声、语义虚假关联和上下文污染的影响。此外,当OOD样本由正常局部组件以异常方式组合而成时,两类方法均难以有效检测。针对这一问题,我们受到Recognition-by-Components理论启发,提出基于组件的OOD检测框架CoOD,将输入分解为具有明确语义的功能组件,并从两个互补角度构建检测证据。其中,Component Shift Score(CSS)通过聚合组件内部特征,在降低局部噪声的同时捕捉细粒度外观变化;Compositional Consistency Score(CCS)则通过建模组件间的语义与几何关系,识别异常的组件组合。CoOD无需额外训练,并在粗粒度、细粒度及组合式OOD检测任务上取得稳定提升。
附件: